- Опубликовано
💸 Дороже не значит лучше
- Автор

- Имя
- 🔥 Дмитрий Ирешев: AI • Продукты • Проекты
- Telegram
- 🔥 Дмитрий Ирешев: AI • Продукты • Проекты12970 подписчиков1068 постовПривет, я Дима Ирешев, Директор продуктов и проектов в e-com На канале ты найдешь 🛒 Разборы крутых проектов и продуктов 🦾 AI & Tech: внедрение нейросетей в работу 🔬 Менеджмент через науку ✉️ Связь: @ireshev 🤡 Мемы: @jokes_in_IT
Кратко
💸 Дороже не значит лучшеИнтересный бенчмарк Bug Hunt Bench, в котором ИИ-модели соревновались в исправлении ошибок в коде.Первое наблюдение: даже...
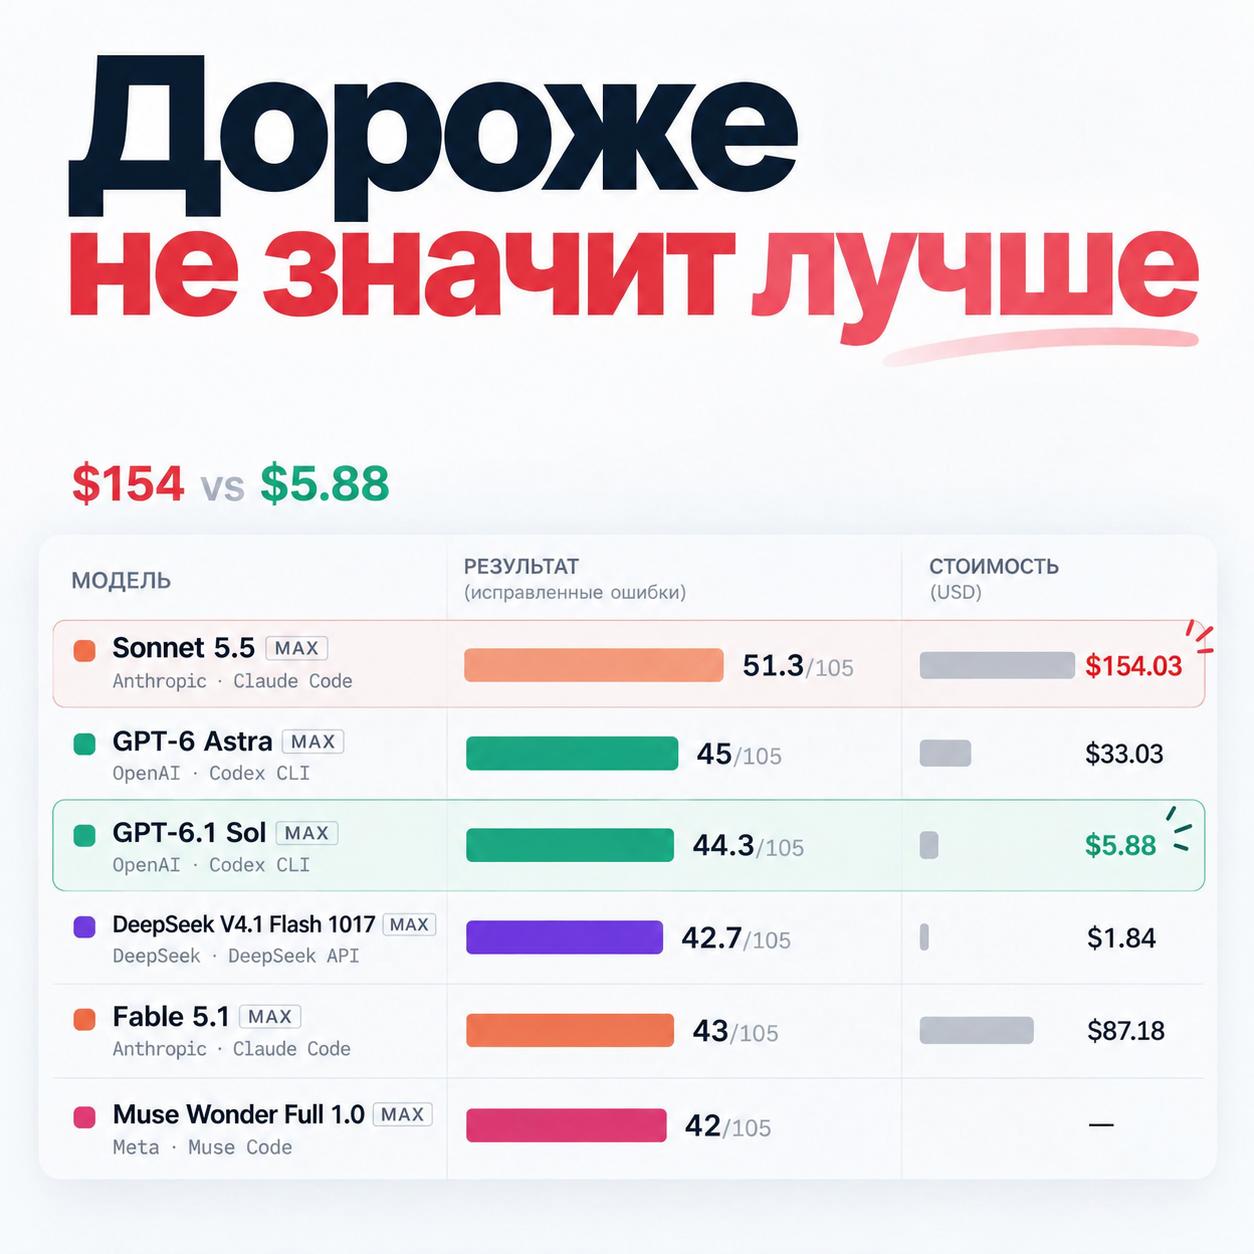
💸 Дороже не значит лучше
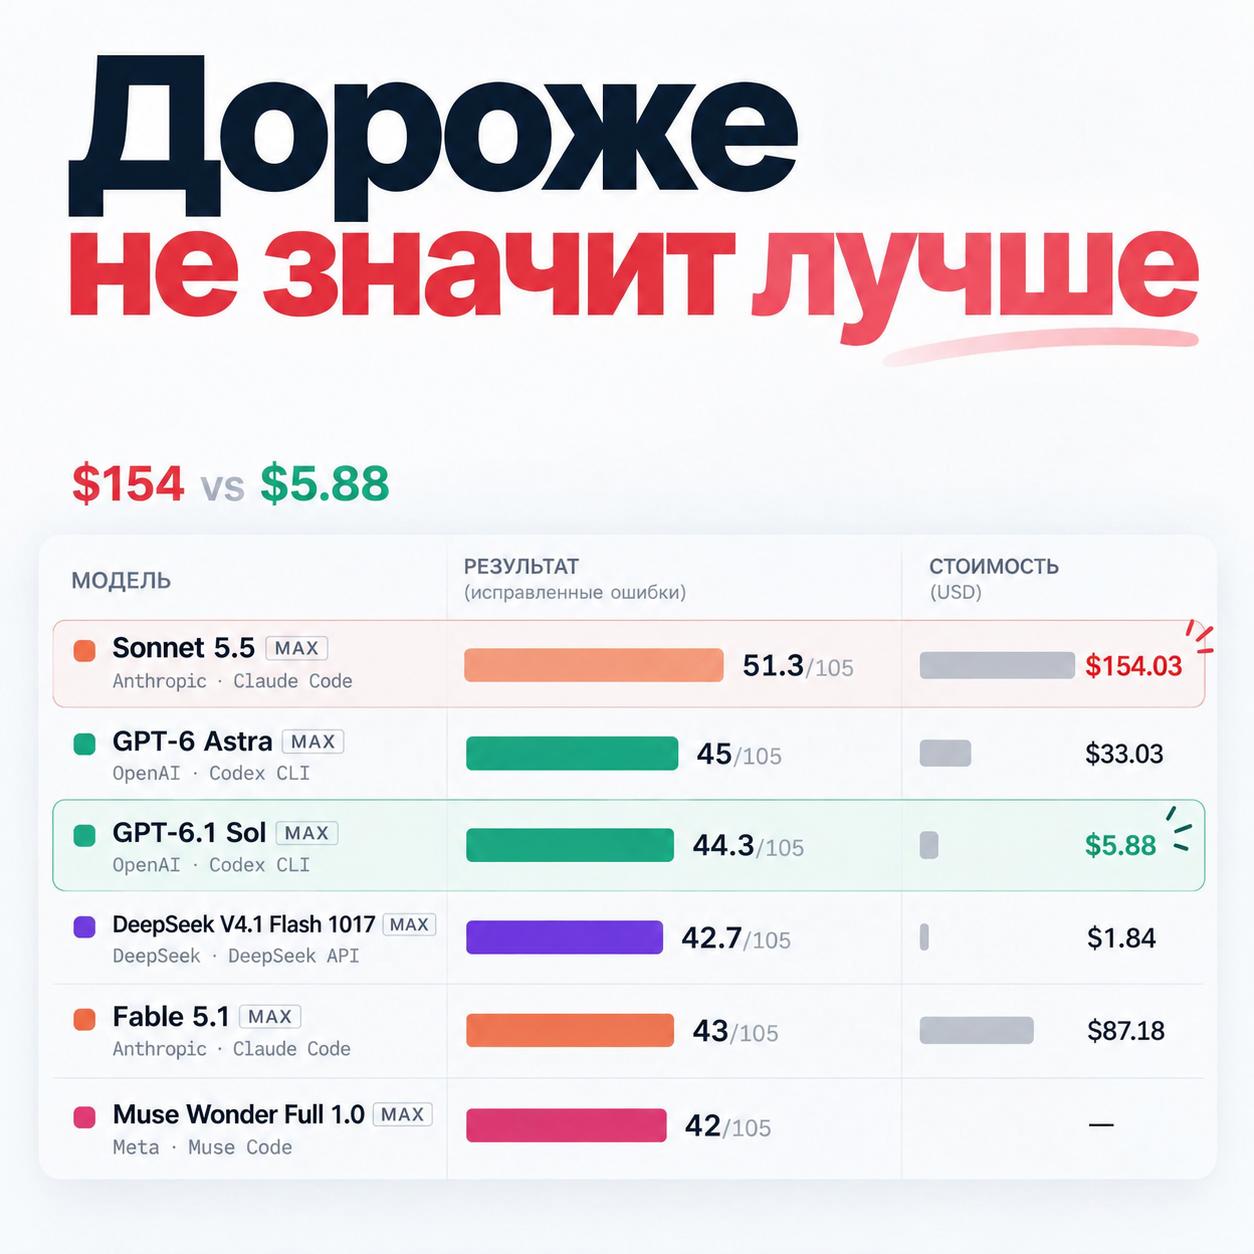
Интересный бенчмарк Bug Hunt Bench, в котором ИИ-модели соревновались в исправлении ошибок в коде.
Первое наблюдение: даже лидер, Claude, исправил только 49% из 105 заложенных ошибок.
Второе: разница в качестве между лидерами небольшая, а вот в стоимости - колоссальная:
🔸 Claude Sonnet 5.5 — 51,3 балла / $154
🔸 GPT-6 Astra — 45 баллов / $33
🔸 GPT-6.1 Sol — 44,3 балла / $5,88
🔸 DeepSeek V4.1 — 42,7 балла / $1,84
Третье: Kimi показала довольно скромные результаты — от 21 до 36 баллов в зависимости от версии и конфигурации.
Лично я сейчас использую GPT-6.1 Sol как универсальную модель и пока не вижу смысла переходить на Claude или Astra. Прирост качества не оправдывает разницу в цене.
Дорогие модели стоит подключать точечно, когда их преимущество действительно окупается. Но сомневаюсь, что у большинства пользователей есть такие задачи. Поэтому ажиотаж вокруг Claude для меня это хайп, чем практическая необходимость.